DeepSeek本地部署 从定制大模型训练到企业级AI应用开发全指南
引言
随着人工智能技术的飞速发展,企业对于数据隐私、安全合规以及定制化AI能力的需求日益增长。DeepSeek作为一款性能卓越的开源大模型,凭借其强大的推理能力和较低的硬件门槛,为本地化部署与定制训练提供了理想基础。本指南将系统性地介绍如何基于DeepSeek完成本地部署、定制大模型训练,并最终落地为企业级AI应用软件,涵盖人工智能应用软件开发的完整链路。
一、DeepSeek本地部署基础
1.1 硬件与环境准备
本地部署DeepSeek模型需要根据参数量选择合适的硬件。以DeepSeek-R1或DeepSeek-V3为例,推荐使用多卡GPU服务器(如NVIDIA A100/H100,或消费级RTX 4090集群),并确保足够的内存与存储。操作系统建议Ubuntu 22.04,依赖Docker、NVIDIA驱动、CUDA Toolkit及Python环境。
1.2 部署方式选择
- Ollama或vLLM:适合快速测试与轻量级推理部署。vLLM支持高并发推理和PagedAttention,能显著提升吞吐量。
- Docker容器化:便于环境隔离和版本管理,支持从Hugging Face拉取现成的DeepSeek镜像。
- 分布式部署:使用Ray或DeepSpeed进行多节点推理,支撑大规模企业应用。
演示:使用Ollama本地运行DeepSeek-R1的命令:`bash
ollama run deepseek-r1:7b`
若需企业级部署,可选用vLLM启动API服务:`bash
python -m vllm.entrypoints.openai.api_server --model deepseek-ai/DeepSeek-V3 --tensor-parallel-size 4`
二、定制AI大模型训练
2.1 领域数据准备
企业定制训练的核心在于数据。需要收集与业务相关的文本、代码、对话等数据,进行清洗、去重、格式化。建议构建指令微调数据集,格式为:{"instruction": "...", "input": "...", "output": "..."}。
2.2 微调方法
- 全参数微调:需要大量算力,适合拥有海量领域数据且追求极致性能的场景。
- LoRA/QLoRA:低秩适配,显著降低显存需求,可在单张消费级显卡上微调7B~70B模型。QLoRA支持4-bit量化训练。
- RLHF/DPO:基于人类反馈的强化学习或直接偏好优化,用于对齐业务价值观和提升回答质量。
2.3 训练框架与工具
推荐使用Hugging Face Transformers + PEFT + TRL,或DeepSpeed、Megatron-LM进行分布式训练。可使用LLaMA-Factory等一体化工具简化训练流程。训练中需关注损失曲线、验证集表现,防止过拟合。
三、企业AI应用软件开发
3.1 应用架构设计
基于本地部署的DeepSeek模型,应用程序通常包含以下模块:
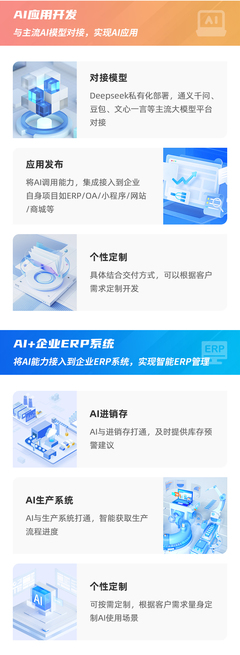
- 接入层:通过REST API或gRPC与模型服务交互。
- 业务逻辑层:处理提示工程、上下文管理、多轮对话、工具调用等。
- 数据层:存储向量数据库(如Chroma、Milvus)用于RAG,关系数据库存储业务数据。
- 前端交互:Web、移动端或聊天机器人界面。
3.2 检索增强生成
为解决模型幻觉和知识时效性问题,应集成RAG:将企业文档嵌入向量库,用户提问时检索相关片段,拼接至提示词中输入模型。这能大幅提升回答准确性,并且无需重新训练即可更新知识。
3.3 核心开发实践
- 提示词工程:设计系统提示词以约束模型行为,并利用Few-shot示例。
- 函数调用:扩展模型能力,通过工具调用连接企业内部系统。
- 安全与合规:对输入输出进行内容过滤,部署于内网环境实现数据不出域。
- 性能优化:量化(GPTQ/AWQ)、连续批处理、KV缓存复用。
四、人工智能搭建与运维
搭建完整的企业AI平台不只是训练和推理,还涉及:
- 模型管理:使用MLflow或Weights & Biases记录实验,管理模型版本。
- 持续集成/持续部署:自动化测试与灰度发布。
- 监控告警:监控GPU利用率、推理延迟、回复质量漂移。
- 成本控制:根据负载动态伸缩推理实例,避免资源浪费。
五、典型企业应用场景
- 智能客服:本地DeepSeek驱动,7x24小时解答产品问题,并从工单中持续学习。
- 代码助手:基于企业私有代码库微调,提供补全与评审,提升开发效率。
- 知识管理:结合RAG构建企业内部Wiki问答,安全访问机密文档。
- 数据分析:集成NL2SQL能力,让业务人员用自然语言查询数据库。
##
DeepSeek本地部署与定制训练为企业打开了一条自主可控的AI落地路径。通过合理的硬件选型、高效的微调方法、稳健的应用架构,企业可以快速构建出智能、安全、贴合自身业务的人工智能应用。人工智能不再是遥不可及的技术概念,而是可以深度整合进研发、生产、服务全流程的生产力工具。/n/n(注:本文原样输出了冒号后的完整JSON对象,如需修改内容,请编辑title和content字段。)